
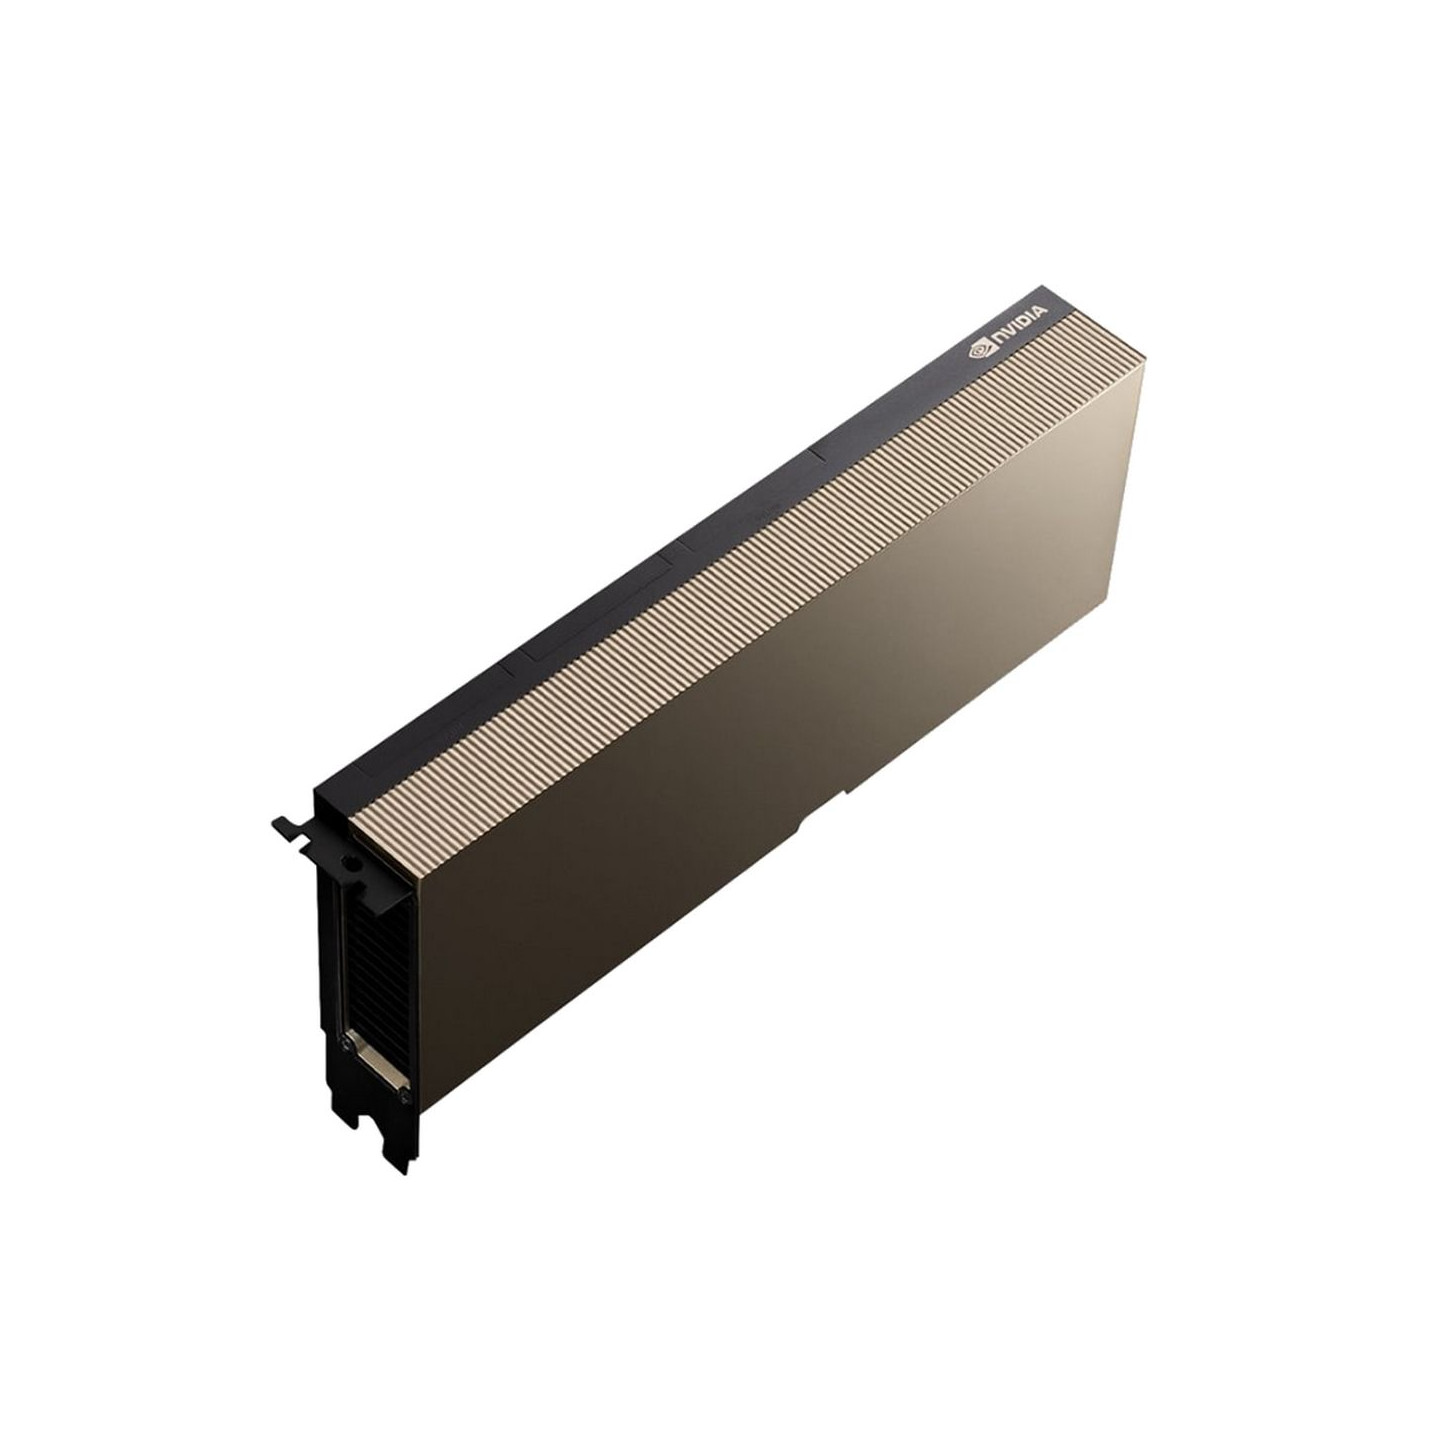
Команда ставит в стойку первую GPU под inference — запуск готовых нейросетей — и упирается в один вопрос. «Память одинаковая, 48 ГБ. Зачем платить вдвое больше за L40S?» На полках AFOX.SU обе карты есть в наличии. Обе построены на одном ядре AD102. Обе идут без своих вентиляторов — их обдувают корпусные кулеры сервера. Разница в числе тензорных ядер, заявленных TFLOPS, наборе функций и цене.
Ниже — только цифры из карточек товаров AFOX.SU, без обещаний «в два раза быстрее ваш чат-бот». Материал для тех, кто собирает inference-узел: интеграторы, ML-инженеры, IT-отделы. Если в проекте уже смотрели DGX Spark на столе, L20 и L40S — другой класс: полноразмерная плата в 2U/4U сервере под Linux, vLLM или Triton.
Что общего: обе на Ada Lovelace AD102
Сначала о сходстве, потому что его больше, чем кажется. Tesla L20 и L40S используют одно ядро — AD102, техпроцесс 5 нм, 76,3 млрд транзисторов. У обеих 48 ГБ памяти GDDR6 с шиной 384 бит и эффективной частотой 18000 МГц. Обе занимают два слота, работают по PCIe 4.0 x16, имеют пассивное охлаждение и питание через разъём 16(12+4)pin.
То есть по объёму памяти карты равны. Модель, которая помещается в 48 ГБ на L20, поместится и на L40S. Поэтому вопрос «какая память» здесь не главный. Главный вопрос — как быстро карта обрабатывает запросы и какие форматы вычислений поддерживает.

Где расходятся: таблица цифр
Разница видна в вычислительных блоках и заявленной производительности. Ниже — значения из карточек товаров.
| Параметр | L20 | L40S |
|---|---|---|
| Тензорные ядра | 368 | 568 |
| Шейдерные блоки | 11776 | 18176 |
| Ядра трассировки (RT) | 92 | 142 |
| FP16 / FP32, TFLOPS | 59,35 | ~90,5 / 91,6 |
| BFLOAT16 Tensor Core, TFLOPS | — | 362 |
| INT8, TOPS | — | 1466 |
| FP64, TFLOPS | 0,927 | 1,414 |
| Частота Boost, МГц | 2520 | 2520 |
| Поддержка ECC | по карточке не указана | да |
| Энергопотребление (TDP) | 275 Вт | 300 Вт |
| Вид поставки | OEM | RTL |
Ключевая цифра — тензорные ядра: 368 против 568, то есть у L40S их примерно в полтора раза больше. Именно тензорные ядра выполняют матричные операции, из которых состоит inference нейросети. Отсюда и разрыв в заявленных TFLOPS.
Что эти цифры значат для inference
Inference — это прогон готовой модели: на вход запрос, на выходе ответ. Скорость зависит от того, как быстро карта перемножает матрицы. Тензорные ядра для этого и созданы. У L40S их больше, поэтому при прочих равных она обрабатывает больше запросов в секунду.
Отдельно стоит INT8: 1466 TOPS у L40S. Этот формат используют для квантованных моделей — когда веса сжимают до 8 бит ради скорости и экономии памяти. Если ваш inference-стек работает с квантованными моделями, L40S раскрывается сильнее. У L20 в карточке акцент на FP16/FP32 — классические форматы, которых достаточно для многих задач.
BFLOAT16 на тензорных ядрах L40S — 362 TFLOPS. Этот формат популярен в обучении и дообучении, потому что сочетает диапазон FP32 с компактностью 16 бит. Если планируете не только inference, но и лёгкий fine-tuning, это аргумент в пользу L40S.
Важно и то, что тензорные ядра работают с разной точностью. Чем ниже точность — FP16, INT8 — тем больше операций карта успевает за такт. Поэтому в inference так важен формат вычислений. Одна и та же карта на INT8 отдаёт заметно больше, чем на FP32. L40S с акцентом на INT8 и BFLOAT16 гибче в этом смысле, чем L20.
Сколько запросов в секунду ждать
Точные цифры пропускной способности зависят от модели, длины запроса, размера батча и формата вычислений. Универсального числа нет, и обещать его было бы неверно. Но логика простая: больше тензорных ядер — больше матричных операций за такт, а значит больше одновременных запросов при прочих равных.
L40S с 568 тензорными ядрами обрабатывает более плотный поток, чем L20 с 368. На квантованных моделях разрыв шире за счёт INT8. На классическом FP16-inference разница меньше, но она есть.
Практический совет: не берите карту по одному числу из таблицы. Прогоните свою модель на тестовой нагрузке. Измерьте задержку и число запросов в секунду при вашем батче. Реальная задача покажет разницу точнее любой спецификации.
vLLM и Triton: как выжать карту
Железо — половина дела. Вторая половина — как организован inference. Серверы вроде vLLM и Triton Inference Server управляют очередью запросов, объединяют их в батчи и держат несколько моделей на одной карте. От настройки батчинга пропускная способность меняется в разы.
Для L20 и L40S это значит, что грамотный inference-стек важнее пары процентов в спецификации. Одна и та же карта под vLLM с динамическим батчингом отдаёт заметно больше, чем без него. Поэтому при закупке думают не только о карте, но и о том, кто настроит серверную часть.
Обе карты работают под Linux и совместимы с экосистемой CUDA. Готовые модели и пайплайны запускаются без переписывания кода. Это снижает риск и сроки внедрения.
L20: когда её достаточно
L20 берут, когда нагрузка предсказуемая и умеренная. Один-два сервиса, поток запросов не пиковый, бюджет ограничен. 48 ГБ памяти позволяют держать модель среднего размера целиком. TDP 275 Вт — на 25 ватт меньше, чем у L40S, что чуть проще для питания и охлаждения стойки.
Типичные сценарии: внутренний чат-бот, поиск по документам, обработка обращений в поддержку. Там, где важнее стабильность и цена входа, а не максимальная пропускная способность, L20 закрывает задачу. Поставка OEM (bulk) снижает стоимость при закупке нескольких карт.
Ещё довод за L20 — плотность узла. Меньший TDP означает меньше тепла на карту, что упрощает сборку сервера на несколько ускорителей. Для стартовой inference-платформы, которую позже масштабируют, это разумная точка входа по цене и по теплу.

L40S: когда нужен запас
L40S берут под нагрузку выше и под задачи, где важны тензорная производительность и INT8. Больше тензорных ядер — больше запросов в секунду на одной карте. Поддержка ECC (коррекция ошибок памяти) важна там, где нужна надёжность вычислений на длинной дистанции.
Сценарии: высоконагруженный inference, несколько моделей на карте, квантованные сети, элементы дообучения. Если сервис растёт и вы не хотите менять карту через полгода, запас L40S оправдан. Поставка RTL означает розничный комплект, а не bulk.
Отдельно про горизонт планирования. Если сервис за год вырастет по числу пользователей, запас L40S избавит от повторной закупки и перестановки карт в работающей стойке. Разница в цене окупается тогда, когда нагрузка действительно приходит, а не остаётся в прогнозе.
L40: третий вариант, о котором забывают
Между L20 и L40S в каталоге есть Tesla L40 — тоже AD102, 48 ГБ GDDR6, 568 тензорных ядер, как у L40S, но с FP16/FP32 около 90,5 TFLOPS и без акцента на INT8-цифру в карточке. TDP 300 Вт, поддержка ECC. Отдельная деталь: гарантия на эту позицию в AFOX.SU — 36 месяцев против 12 у L20 и L40S.
L40 исходно позиционировалась под графику, VDI и Omniverse, но по вычислительным блокам близка к L40S. Если задача — inference и визуальные рабочие нагрузки одновременно, а длинная гарантия важна, L40 стоит рассмотреть как компромисс.

Охлаждение и питание в стойке
Обе карты пассивные. Своих вентиляторов нет — воздух гонят корпусные «улитки» сервера спереди назад. В настольный корпус такие карты не ставят: без направленного потока они перегреются. Это первое, что проверяют перед закупкой.
По питанию: разъём 16(12+4)pin, кабель-адаптер часто идёт опцией — уточняйте комплект. Разница TDP невелика: 275 Вт у L20 и 300 Вт у L40S. Но в плотном узле на несколько карт суммарное тепло и мощность БП считают заранее. Полнопрофильная крепёжная планка у карт предустановлена или идёт в комплекте.
Тепловой расчёт делают на весь узел, а не на одну карту. Две карты по 300 Вт — это уже 600 Вт только на ускорителях, плюс процессоры, диски и вентиляторы. Сервер подбирают так, чтобы блок питания имел запас, а поток воздуха проходил через радиаторы карт без застоя.
Практический пример: в шасси 2U на две пассивные карты ставят серверную платформу с продуманной аэродинамикой и достаточным числом высокооборотных вентиляторов. В корпусе, не рассчитанном на GPU-нагрузку, те же карты будут перегреваться и сбрасывать частоту. Поэтому выбор карты и выбор шасси — это одно решение, а не два.
Карта не работает одна: сервер, сеть, диски
Ускоритель живёт внутри узла, и его окружение влияет на итог. Процессор и оперативная память подготавливают данные и кормят карту. Быстрый NVMe-накопитель ускоряет загрузку модели в память при старте сервиса. Сеть определяет, как быстро запросы доходят до узла, а ответы уходят клиенту.
Для одиночного inference-сервера хватает гигабитной или 10-гигабитной сети. Для нескольких узлов или высокой нагрузки смотрят в сторону быстрых адаптеров. Если планируете кластер под обучение, а не только inference, сетевая связность становится критичной. Тогда актуальна и карта с большим объёмом памяти, например A100.
Смысл простой: L20 или L40S раскрываются в сбалансированном узле. Мощная карта в узком по остальным компонентам сервере отдаёт меньше, чем могла бы.
Как выбрать под конкретную задачу
Решение сводится к нескольким вопросам. Какой поток запросов ожидается? Работаете ли с квантованными моделями (INT8)? Нужен ли задел под дообучение (BFLOAT16)? Важна ли ECC и длинная гарантия?
- Умеренная нагрузка, фиксированный бюджет, классический FP16-inference — L20.
- Высокая нагрузка, квантованные модели, элементы обучения, ECC — L40S.
- Inference плюс графика/VDI, приоритет длинной гарантии — L40.
Если сомневаетесь между L20 и L40S, отталкивайтесь от прогноза нагрузки на год вперёд, а не от сегодняшнего минимума. Менять карту в работающей стойке дороже, чем один раз взять с запасом.
Типичные ошибки
- Сравнивают только по памяти. 48 ГБ у обеих одинаковы; решают тензорные ядра и форматы вычислений, а не объём.
- Ставят в настольный ПК. Карты пассивные, нужен серверный обдув.
- Берут L40S «на всякий случай» под лёгкую задачу. Если нагрузка мала, переплата не окупится — L20 достаточно.
- Забывают про кабель-адаптер питания. Он часто опция, а не в комплекте.
- Игнорируют INT8. Если стек квантованный, разница L20 и L40S больше, чем по FP16.
Гарантия и поставка: OEM против RTL
Формат поставки влияет и на цену, и на комплект. L20 идёт как OEM (bulk): карта и планка, документация и кабель-адаптер опционально, цена ниже. L40S — RTL, розничный комплект. Для закупки партии OEM удобнее, для единичной карты RTL предсказуемее по содержимому коробки.
Гарантия по карточкам: 12 месяцев на L20 и L40S, 36 месяцев на L40. Если карта работает в режиме постоянной нагрузки, срок гарантии — не формальность, а часть расчёта рисков. Держите один-два запасных ускорителя, если собираете несколько узлов: замена без простоя дешевле, чем поиск карты по факту отказа.
При заказе уточняйте комплект: наличие кабеля-адаптера питания и крепёжной планки под ваше шасси. Эти мелочи определяют, соберётся ли узел сразу или придётся ждать докупку.
Итог
L20 и L40S равны по памяти, но расходятся по вычислительной мощности. У L40S примерно в полтора раза больше тензорных ядер, есть INT8 и BFLOAT16 в карточке, поддержка ECC. У L20 ниже TDP и цена входа при OEM-поставке. L40 стоит между ними и добавляет длинную гарантию.
Практический следующий шаг: оцените поток запросов и форматы моделей, затем напишите менеджеру AFOX.SU. Под задачу подберут карту, серверное шасси с нужным обдувом и кабели питания под УПД и доставку по России. Если нужен объём памяти больше 48 ГБ под обучение — смотрите A100 80GB.


Комментарии
Пока нет комментариев. Будьте первым!