
«Нужны GPU под обучение и inference в стойку, бюджет — на партию, а не на одну коробку из розницы.» С таким запросом приходит и команда, поднимающая свою языковую модель, и интегратор, собирающий вычислительный узел для заказчика. Розничная полка тут не выручает: игровые видеокарты не дают нужного объёма памяти и не рассчитаны на пассивное охлаждение в серверном шасси.
В каталоге AFOX.SU под эту задачу есть позиция NVIDIA Tesla A100 80GB в OEM-поставке (bulk packing) — партия в наличии, партномер 900-21001-0020-100. Ниже разбираем, что стоит за этой картой по данным её карточки, когда Ampere-поколение остаётся практичным выбором и как собрать вокруг него рабочий узел. Без обещаний «в десять раз быстрее»: A100 не заменяет новые ускорители там, где нужен свежий класс памяти, но для многих задач её ресурса достаточно, а цена OEM-партии заметно ниже розницы.
Материал для тех, кто закупает вычислители: ML-команды, серверные интеграторы, IT-отделы, которым нужен локальный контур для данных, не уходящих в облако.
Что такое A100 80GB bulk и откуда такая поставка
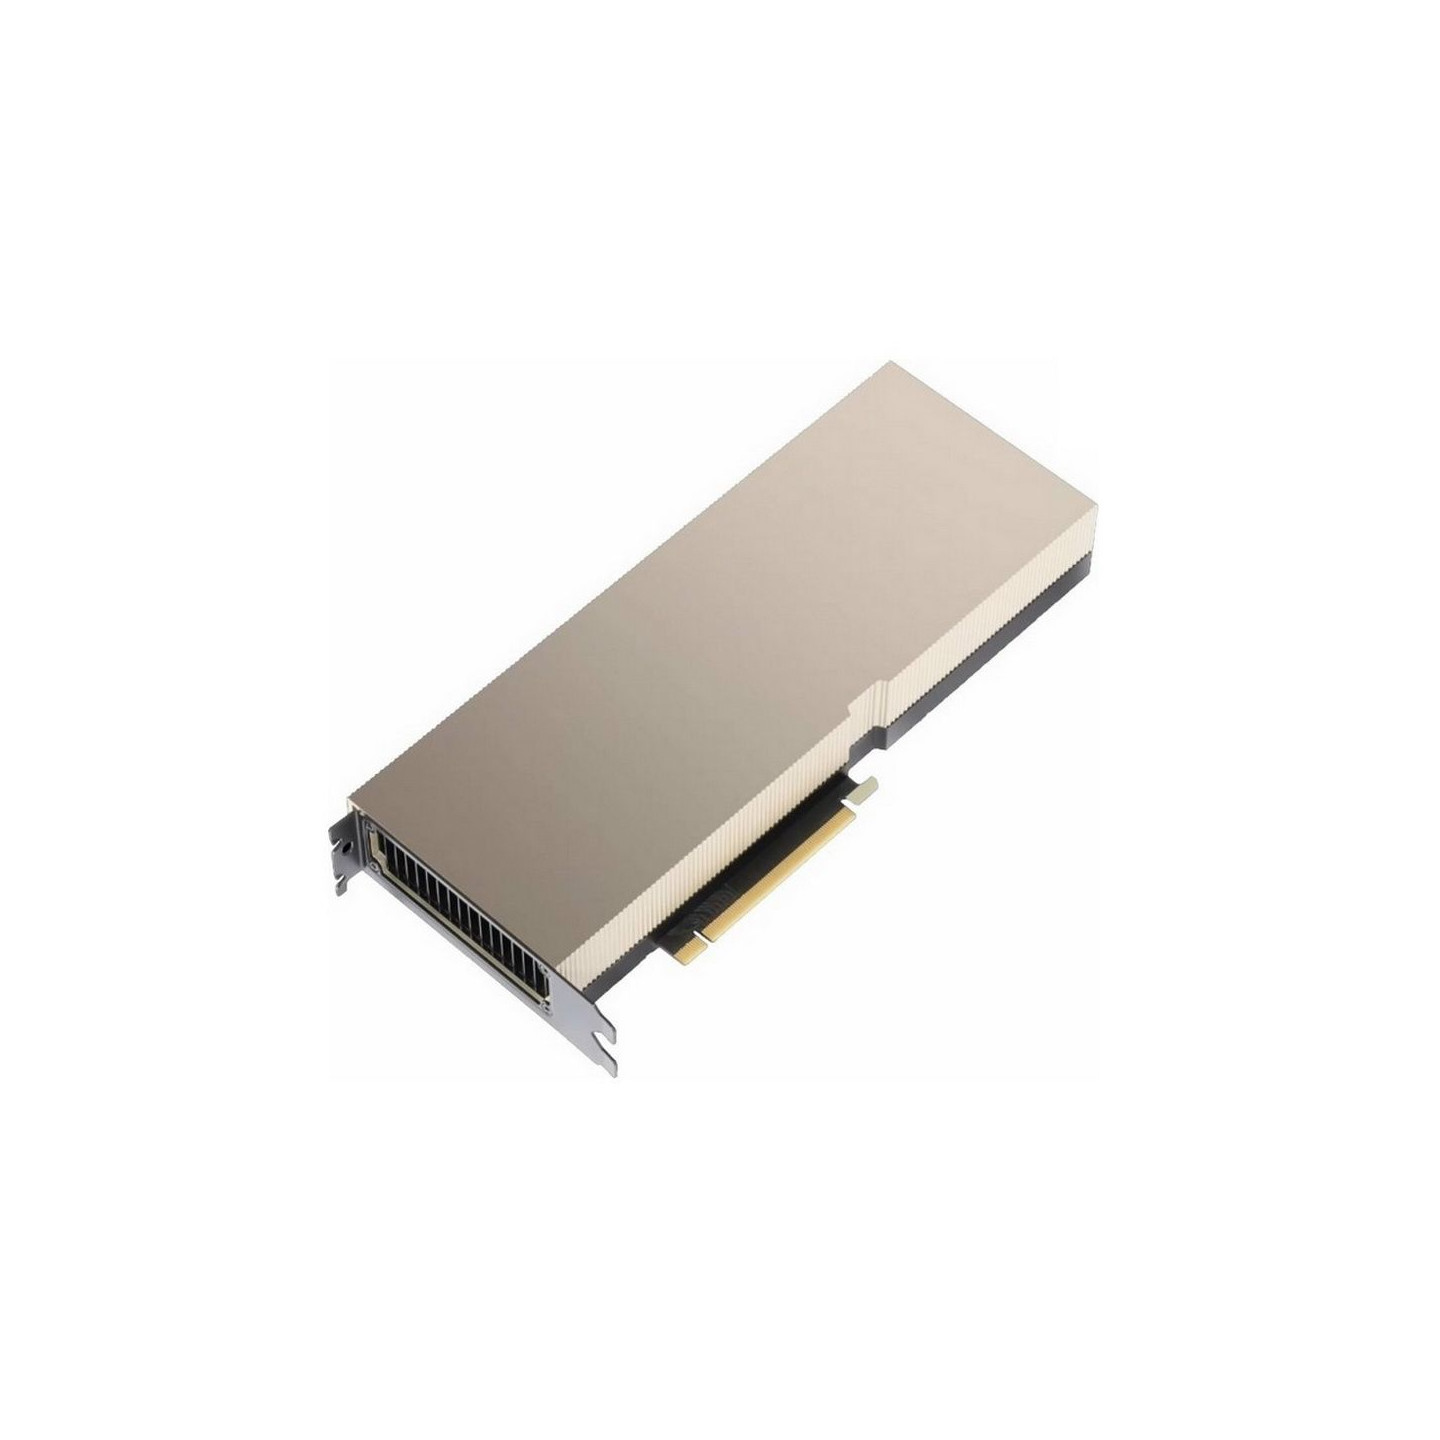
A100 — ускоритель вычислений на архитектуре Ampere, ядро GA100, техпроцесс 7 нм, 54,2 млрд транзисторов. Формат — PCIe-плата двойной ширины, интерфейс PCI Express 4.0 x16, длина 268 мм, высота 114 мм. Важное отличие от игровых карт: охлаждение пассивное, на плате нет своих вентиляторов — воздух через радиатор гонят корпусные «улитки» сервера. Поэтому A100 живёт в серверном шасси, а не в настольном корпусе.
Пометка «bulk packing» и Disassembly означает OEM-поставку без розничной коробки: карта, крепёжная планка, опционально документация. Для закупки партии это норма — вы платите за кремний и гарантию, а не за упаковку. Гарантия на позицию в AFOX.SU — 12 месяцев. Такой формат удобен, когда нужно собрать сразу несколько одинаковых узлов и держать запас на замену.

Реальные характеристики: цифры из карточки
Ключевое в A100 80GB — память. Это 80 ГБ HBM2e с шиной 5120 бит: такой объём и пропускная способность отличают ускоритель от потребительских карт с 8–24 ГБ GDDR. Для обучения и дообучения моделей, где веса и активации должны поместиться в память одной карты, это решающий параметр. Когда модель не влезает в память, начинается обмен с оперативной памятью хоста, и скорость падает в разы.
| Параметр | A100 80GB (по карточке) |
|---|---|
| Архитектура / ядро | Ampere, GA100, 7 нм |
| Память | 80 ГБ HBM2e, шина 5120 бит |
| Тензорные ядра | 432 |
| Интерфейс | PCI Express 4.0 x16 |
| NVLink | до 600 Гбит/с между картами |
| Энергопотребление (TDP) | 300 Вт |
| Охлаждение | пассивное, обдув корпусными вентиляторами |
| MIG | до 7 изолированных инстансов на карту |
NVLink на 600 Гбит/с важен, когда одной карты мало и нужно связать несколько A100 в пул с быстрым обменом. При обучении на нескольких GPU шина PCIe становится узким местом, а NVLink его снимает, позволяя картам обмениваться градиентами напрямую. Пассивный радиатор и TDP 300 Вт — это ещё раз про то, что карте нужен серверный поток воздуха, а не корпусный кулер.
MIG: одна карта как семь
Multi-Instance GPU (MIG) — характерная особенность A100: физическую карту можно поделить на срезы, до семи изолированных инстансов, каждый со своей долей памяти и вычислительных блоков. Это меняет экономику inference. Вместо того чтобы отдавать одну дорогую карту под одну модель, вы запускаете на ней несколько независимых сервисов: чат-бот поддержки, обработку документов, распознавание — и каждый работает в своей «песочнице» без влияния соседей.
Для хостинга нескольких небольших моделей 80 ГБ памяти, поделённые через MIG, часто выгоднее набора отдельных карт по 24 ГБ: меньше слотов PCIe, ниже энергопотребление узла, проще обслуживание. На практике команды выделяют один крупный инстанс под тяжёлую модель, а оставшийся ресурс режут на мелкие срезы под вспомогательные задачи — например, эмбеддинги или классификацию.
Сколько A100 нужно под задачу
Частый вопрос закупки — сколько карт брать. Ответ зависит от размера модели и режима работы. Для дообучения рабочий набор весов и активаций должен поместиться в память карты. В 80 ГБ HBM2e умещается заметный объём, поэтому для старта fine-tuning нередко хватает одной A100.
Когда параметров больше или нужна скорость, ставят две–четыре карты и связывают их через NVLink. Карты делят модель между собой и обмениваются данными по шине 600 Гбит/с. Шина PCIe при этом перестаёт быть узким местом, а время эпохи сокращается.
Для inference логика обратная. Одна карта через MIG обслуживает несколько моделей сразу, каждую в своём срезе. Если сервис один, но нагруженный, ему отдают карту целиком без разбиения.
Практический ориентир для планирования: считайте не «сколько GPU», а «сколько памяти и какая пропускная способность» нужны конкретной модели. Под этот ответ уже подбирают число карт и топологию узла. Такой расчёт бережёт бюджет: лишние карты не покупаются, а нужные берутся с запасом памяти.
Программный стек: на чём это работает
A100 совместима с экосистемой CUDA, и это её сильная сторона в закупке. Готовые пайплайны на PyTorch или TensorFlow, драйверы, библиотеки cuDNN и NCCL для многокарточного обучения запускаются без переписывания кода. Для развёртывания inference-сервисов используют vLLM или Triton Inference Server — они умеют работать с MIG-инстансами и держать несколько моделей на одной карте.
Практический смысл: если у команды уже есть обученные модели и рабочий код под Ampere, переход на A100-узел не требует миграции. Это экономит недели, которые ушли бы на адаптацию под новую архитектуру, и снижает риск закупки — вы берёте проверенную платформу, а не пионерское железо.
Пример из практики. Команда держит на одном узле дообученную модель для внутреннего поиска и отдельный сервис суммаризации документов. Через MIG обе модели живут на одной A100, каждая в своём срезе памяти. Обновление одной не задевает другую. Это упрощает эксплуатацию и снижает число карт, которые нужно закупить и обслуживать.
Локальный контур: когда данные не должны уходить в облако
Отдельный мотив покупки своих ускорителей — требования к данным. Для многих компаний персональные данные, коммерческая тайна или отраслевые регламенты не позволяют обрабатывать информацию во внешнем облаке. Локальный узел на A100 снимает вопрос: и обучение, и inference идут на своём железе, в своём периметре.
Это касается госсектора, финансов, медицины, промышленности. Свой вычислитель означает контроль над тем, где физически лежат данные и кто имеет к ним доступ. При закупке этот довод часто перевешивает удобство аренды.
Есть и денежная сторона. Аренда GPU в облаке считается по часам и растёт вместе с нагрузкой. Свой узел — это фиксированный капитальный расход и известная стоимость эксплуатации. Когда модель работает постоянно, а не эпизодически, собственное железо окупается предсказуемо. Облако удобнее для разовых экспериментов, локальный контур — для постоянной нагрузки.
HBM2e против GDDR6: почему именно A100
Соседние по каталогу карты — Tesla L20 и L40S — построены на Ada Lovelace (AD102, 5 нм) и несут 48 ГБ GDDR6 с шиной 384 бит. По «сырым» числам они сильны: L40S выдаёт около 362 TFLOPS на тензорных ядрах в BFLOAT16, L20 — порядка 59 TFLOPS FP16. Но тип памяти другой: GDDR6, а не HBM2e. Для inference готовых моделей этого достаточно, и сравнению L20 против L40S посвящён отдельный разбор.
A100 берут туда, где важна именно пропускная способность памяти: обучение и дообучение, работа с большими батчами, задачи HPC с двойной точностью. Широкая шина HBM2e кормит вычислительные блоки данными быстрее, чем GDDR6, и на memory-bound задачах это ощутимо. Если же контур — только inference на столе разработчика, посмотрите в сторону DGX Spark: это отдельный класс устройства для настольной разработки.

Когда Ampere выгоднее нового поколения
Новые ускорители дают больше, но и стоят кратно дороже, а сроки поставки длиннее. A100 80GB остаётся практичным выбором в нескольких случаях:
- Бюджет фиксирован, а задача — обучение моделей среднего размера, где 80 ГБ на карту достаточно.
- Нужна партия сразу: OEM-поставка bulk закрывает потребность в нескольких узлах без долгого ожидания.
- Уже есть код и пайплайны под CUDA и Ampere — миграция не нужна, всё запускается «как есть».
- Inference с MIG: одна A100 обслуживает несколько сервисов, экономя слоты и питание.
Для входа в профессиональные вычисления с минимальным энергопотреблением есть бюджетный вариант — RTX A2000 6GB: низкопрофильная карта на 70 Вт с активным охлаждением, для рабочих станций и лёгких задач, где A100 избыточна. Её ставят туда, где нужен CUDA под рукой, но нет серверного шасси.

Сеть и стойка: как собрать узел
Одна карта редко живёт в вакууме. Чтобы A100 отдавала ресурс кластеру, узел связывают быстрой сетью. Здесь помогают адаптеры Mellanox ConnectX-6: модель MCX653106A-HDAT даёт два порта QSFP56 и скорость до 200 Гбит/с на порт (InfiniBand HDR или 200GbE), интерфейс PCIe 4.0 x16. Для распределённого обучения, где градиенты гоняются между узлами, пропускная способность сети напрямую влияет на время эпохи.
По питанию и охлаждению: 300 Вт на карту нужно заложить в расчёт блока питания и продумать поток воздуха — пассивный радиатор A100 рассчитан на серверный обдув спереди назад. В шасси на несколько карт следят за суммарным теплом и подбирают модель сервера с достаточным числом «улиток». Для карт формата Tesla T4/P4 в шасси Supermicro есть отдельные крепёжные планки — деталь, о которой забывают при сборке узла.
Ещё один момент — линии PCIe. A100 занимает полноскоростной слот x16. На многокарточном узле важно, чтобы каждая карта получила свои линии от процессора, а не делила их через коммутатор. Это влияет на скорость загрузки данных в память карты. При выборе серверной платформы смотрят на число слотов x16 и схему их разводки по процессорам.
Типичные ошибки закупки
- Ставят в настольный корпус. У A100 нет своих вентиляторов. Без серверного обдува карта уйдёт в троттлинг или перегреется — нужен корпус с прямым потоком воздуха.
- Не закладывают питание и охлаждение узла. 300 Вт на карту плюс процессоры и диски — считайте суммарную нагрузку и запас БП заранее.
- Ждут видеовыходы. Это вычислительный ускоритель, а не видеокарта для монитора. Дисплей подключают к встроенной графике сервера.
- Берут одну карту под несколько тяжёлых моделей без MIG. Планируйте разбиение заранее, иначе сервисы будут конкурировать за ресурс.
- Игнорируют формат поставки. Bulk/OEM — норма для партии, но уточните комплект (планка, кабель-адаптер питания) у менеджера до заказа.

Экономика партии и запас на замену
OEM-партия A100 привлекательна не только ценой самой карты. В расчёт входит совместимость: код под CUDA и Ampere не нужно переписывать. Входят сроки: партия в наличии против ожидания поставки нового поколения. Входит энергопотребление: 300 Вт на карту — предсказуемая величина для расчёта питания стойки.
При закупке на несколько узлов держат запас на замену. Одна–две карты из партии остаются в резерве. Тогда вышедший из строя ускоритель меняется без простоя кластера. Bulk-поставка это упрощает: карты из одной партии одинаковые, с единой гарантией 12 месяцев.
Такой подход снижает не разовую цену, а стоимость владения на горизонте эксплуатации. Для бизнеса, который считает сроки проекта и цену простоя, это часто важнее пиковых TFLOPS на бумаге. Поэтому Ampere-партию сравнивают с новым поколением не по одному числу, а по совокупности: цена, сроки, совместимость, обслуживание.
Итог
NVIDIA A100 80GB в OEM-партии — это прежде всего про память. 80 ГБ HBM2e и широкая шина закрывают обучение и дообучение моделей. А MIG превращает одну карту в несколько независимых сервисов для inference. Ampere не догоняет новое поколение по пиковым цифрам. Но она даёт предсказуемую цену за партию, короткие сроки поставки и совместимость с готовыми CUDA-пайплайнами. Если задача — inference без обучения, сравните карту с L40, L20 и L40S. Если нужен настольный контур для разработки — с DGX Spark.
Практический следующий шаг: напишите менеджеру AFOX.SU число карт, модель сервера-шасси и тип сети — под это подберут комплект (адаптеры Mellanox, крепёж, кабели-переходники питания) под УПД и доставку по России.


Комментарии
Пока нет комментариев. Будьте первым!